衡量AI智能体如何处理日常湿实验室科学工作
来源:OpenAI Blog
本文为资讯聚合内容,版权归原作者及原网站所有,如有侵权请联系删除。
推出 BioBasicsBench,这是一个基准测试,用于衡量 AI 智能体在 100 项常规湿实验室任务中解读原始实验数据的能力。
我们的使命是确保人工通用智能惠及全人类。作为这一使命的一部分,我们希望帮助科学家加速生物学研究——从理解疾病到开发新疗法。要让 AI 智能体做出贡献,它们需要可靠地解读科学家每天在湿实验室中处理的实验证据,科学家在那里用生物样本进行实验。日常湿实验室工作涉及失败的实验、模糊的图像和相互矛盾的观察结果。现有基准测试围绕为科学论文挑选的图表和图像构建,可能忽略这种模糊性及其所需的故障排查。这就是我们推出 BioBasicsBench 的原因,这是一个与 Ligo 共同开发的新基准测试,Ligo 是一家专注于酶设计的生物技术公司,旨在衡量智能体处理常规湿实验室分析的能力。
该基准测试的 100 项任务检验智能体能否解读原始实验数据、识别错误,并识别证据何时无法支持结论。正确完成这些任务很重要,因为误读图像或忽视用于检查实验结果的对照问题,可能导致科学家得出错误结论,并把时间花在无法帮助回答其问题的实验上。
在“xhigh”设置下(该设置允许每项任务进行更多推理),GPT‑6 Astra 平均获得可用分数的 66.7%,而 GPT‑5.6 Sol 为 43.8%。结果表明常规实验室分析取得了进展,但在解读图像、检查对照和应用实验背景方面仍有进一步改进的空间。
BioBasicsBench 使用原始实验证据,从凝胶图像和菌落平板到显微镜和仪器读数。
BioBasicsBench 包含 100 项任务,涵盖常规湿实验室工作的五个领域:蛋白质方法、成像与细胞术、定量与测定、核酸方法以及分子克隆。任务范围从简单请求(例如读取凝胶中 DNA 样本的分子量)到详细的测定分析,但都涉及湿实验室科学家应能可靠完成的常规工作。
科学家使用自己实验的数据创建了这些任务,并为每个问题配以专家编写的评分标准。每项任务都经过了未编写该任务的 Ligo 科学家的内部审查、在湿实验室工作的博士级科学家的外部审查,以及最终的内部审查。
智能体返回结构化答案,包含所要求的结论、测量值或建议,并在需要时提供支持性推理。答案根据各项评分标准获得分数,使该基准测试能够区分正确结论与部分正确的分析。大多数任务同时测试多项技能,包括生物学知识、图像和其他数据的解读、错误检测以及实验方案理解。
“唯一任务”将每项任务计一次。技能列统计带有各技能标签的任务。这些类别存在重叠:一项任务可能出现在多列中,因此技能计数不应相加以获得任务总数。颜色标识领域;较深的阴影表示该领域中测试某项技能的任务占比更大。
输入保留了科学家所处理的证据形式:凝胶和印迹图像、平板照片、显微镜堆叠图像、测序读段、酶标仪导出文件和实验台操作视频。一项任务可以包含多种数据。参考表(如分子量标准图表和质粒图谱)支持对实验证据的解读。
| 数据类型 | 任务数 | 包含内容 |
|---|---|---|
| 凝胶与印迹 | 31 | 琼脂糖 DNA 凝胶、SDS-PAGE 凝胶、Western 印迹 |
| 实验方案、笔记与规格 | 27 | 实验方案与 SOP、实验室笔记本和运行记录、手写笔记照片、目录、仪器规格、已发表方法 |
| 表格与仪器导出 | 20 | CSV 和 Excel 导出、泳道布局与清单、原始流式细胞术(FCS)文件 |
| 实验台、仪器与试剂照片 | 18 | 实验台、凝胶电泳槽、试剂与培养管、PCR 板、试管架、pH 试纸、浓缩仪、冰箱、液体处理工作站台面 |
| 显微镜 | 14 | 原始明场和荧光图像、多通道图像集、Z 轴堆叠、延时视频 |
| 仪器屏幕与图表 | 13 | 流式细胞仪、显微镜、NanoDrop、酶标仪和天平屏幕的照片;导出的标准曲线、色谱图和图表 |
| 测序文件 | 12 | 原始长读长 FASTQ、FASTA 序列、GenBank 图谱 |
| 实验方案视频 | 7 | 划线、接种、梯度稀释、SDS-PAGE 电泳槽和培养箱设置、天平称量 |
| 琼脂平板与菌落 | 7 | 转化平板、蓝白斑筛选、抗生素纸片平板 |
| 参考表 | 21 | 梯形图、质粒图谱、pH 图表(辅助材料) |
包含各类数据的任务数量。类别有重叠;参考表为辅助材料。
科学家使用自己实验中的数据编写任务,将实验证据与问题和专家编写的评分标准配对。每个任务都经过一位未参与编写的 Ligo 科学家的内部审查、一位从事湿实验室工作的博士级科学家的外部审查,以及最终的内部审查。审查者检查了提示、实验证据、评分标准、作者注释和一份已评分的模型作答。
答案根据任务的评分标准评分,该标准对各项具体标准赋予分数。视任务而定,这些标准评估结论、数值结果、支持性推理,或对证据不足的认识。
我们在 BioBasicsBench 上评估了七个模型:GPT‑5.2、GPT‑5.4、GPT‑5.5、GPT‑5.6 Sol、GPT‑6.1 Sol、GPT‑6 Luna 和 GPT‑6 Astra。评估涵盖 37 种模型与推理强度设置,每种设置在 100 个任务上各尝试五次,共计 18,500 个结果。
我们报告平均奖励:平均任务得分,以可用分数的百分比表示。误差条显示 95% 置信区间,通过重采样整个任务计算,每个任务的五次尝试保持在一起。
平均奖励与每任务平均输出 token 数的关系,采用对数刻度显示。每个点代表一种测试的推理强度设置;线条按顺序连接这些设置。x 轴每个刻度翻倍。橙色虚线表示 GPT‑5 模型,蓝色实线表示 GPT‑6 模型。淡色须线显示 95% 全任务自助法置信区间。每种设置包含全部 100 个任务,每任务五次尝试。各模型的强度设置不同。
即使在低推理强度下,GPT‑6 Astra 也大幅优于 GPT‑5.6 Sol。这些提升表明,更强的原生多模态能力可能是提升日常湿实验室分析表现的关键。
xhigh 推理强度下的表现
| 模型 | 平均奖励 | 95% CI | 输出 token / 任务 |
|---|---|---|---|
| GPT‑6 Astra | 66.7% | 60.3–73.1% | 4,704 |
| GPT‑6.1 Sol | 62.0% | 55.6–68.4% | 5,238 |
| GPT‑5.6 Sol | 43.8% | 37.6–50.0% | 9,099 |
| GPT‑6 Luna | 38.3% | 32.3–44.5% | 13,120 |
| GPT‑5.5 | 35.4% | 29.7–41.0% | 11,135 |
| GPT‑5.4 | 33.2% | 28.3–38.4% | 13,717 |
| GPT‑5.2 | 31.2% | 26.2–36.3% | 27,620 |
Xhigh 是所有七个模型报告的最高推理强度设置。每行包含全部 100 个任务,每个任务五次尝试。最高强度结果(如有)已包含在上图中。
科学中的一个常见陷阱是过度解读数据,尤其是考虑到检验假设时出现的偏差性质。Astra 展现出更好的能力,能够辨别数据所显示内容的界限,而不得出没有根据的结论。
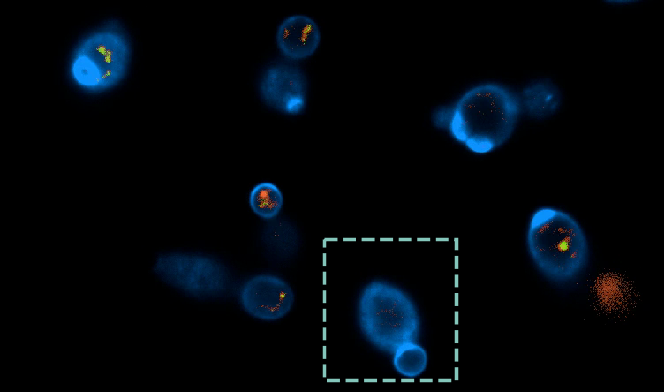
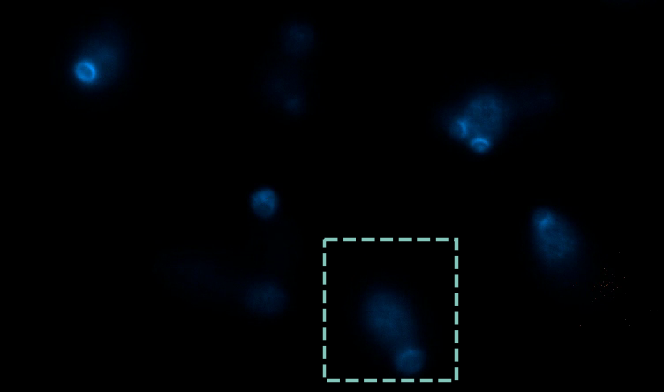
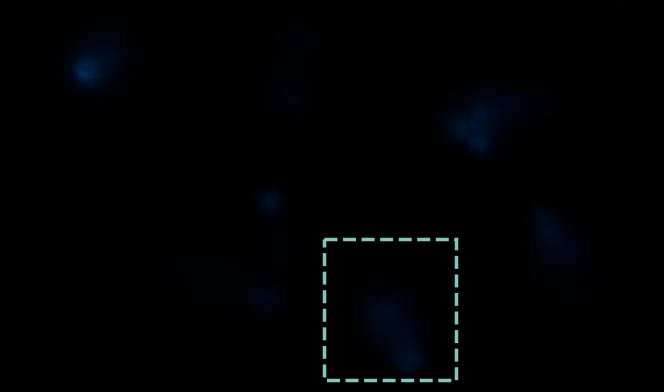
在这个例子中,GPT‑5.6 Sol 根据用于检测死细胞的染料信号将细胞分类为死亡。但检测器也可能接收到第二种染料的光,因此仅凭亮度无法证明该结论。Astra 识别出这种模糊性,并呼吁采用更好的对照来分离信号。
明场 · 透射光
通道 2 · SYTOX 标记 · 470–540 nm
通道 3 · FUN-1 绿色 · 525–580 nm
三个通道中的相同细胞区域;检测窗口在 525–540 nm 处重叠。共享窗口允许干扰;其量尚未测量。每个通道以单独的线性强度标度显示,在两个区域间固定;亮度无法在通道间进行定量比较。
科学研究高度多模态,需要持续的视觉解读和决策。Astra 在处理以照片和视频形式提供的多模态数据,以及测序、板阅读器测定、显微镜和流式细胞术的原始输出方面,表现出显著改进。
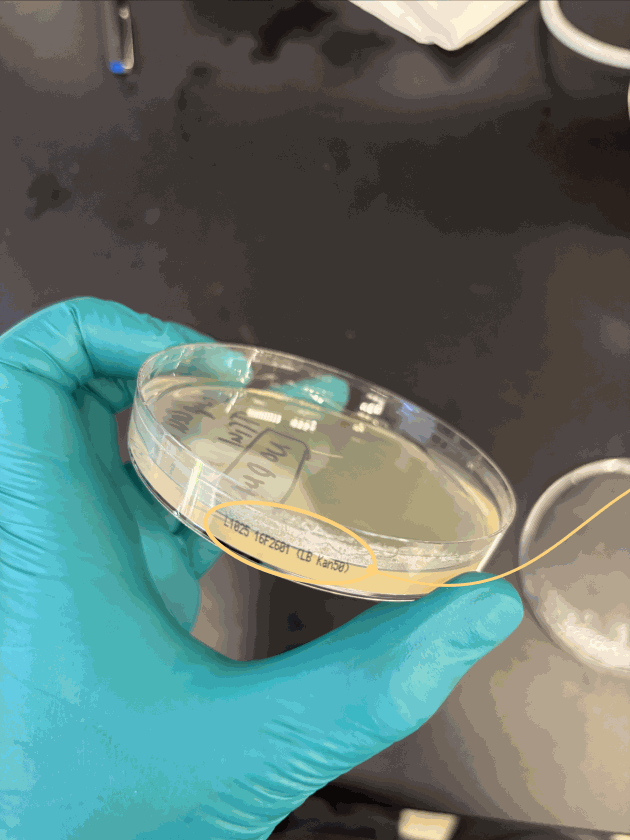
在最基本的层面上,这种改进通过 GPT‑6 Astra 从实验期间拍摄的图像中捕捉更精细细节的能力而显而易见,从而得出更准确的结论,如本示例所示。该任务要求智能体从 DNA 克隆实验中得出结论,其中对照至关重要。GPT‑5.6 Sol 在阴性对照板上未看到菌落,并基于该观察得出结论。GPT‑6 Astra 注意到该板标记了错误的抗生素,并正确地将其拒绝为可靠对照。
原始照片
边缘上的标签
原始基准照片,边缘标签已圈出并放大。“LB Kan50”标识卡那霉素,一种与实验中所用氨苄青霉素不同的抗生素。
科学家必须能够在分析数据时牢记隐性生物学知识和实验背景,以正确解读其所显示的内容。Astra 展现出在分析过程中保持并应用这种背景的改进能力。
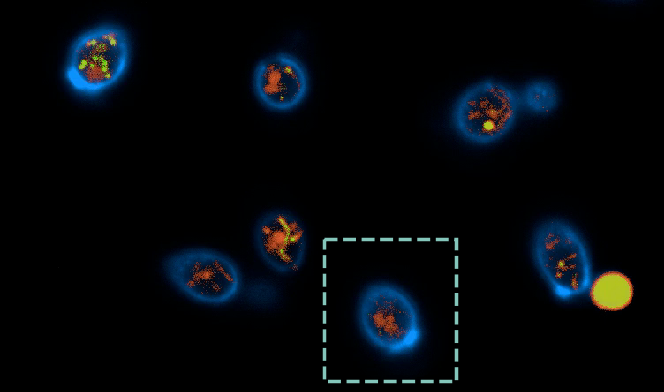
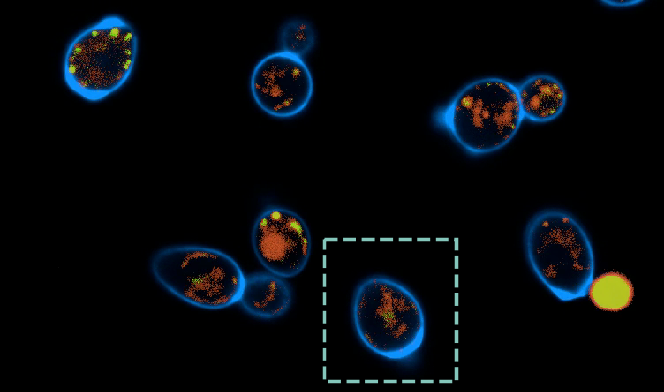
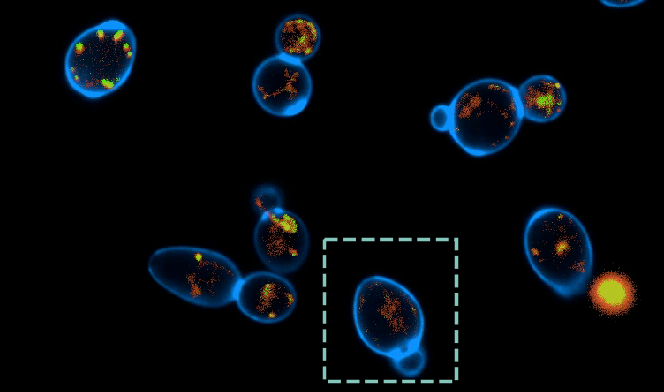
一项任务显示细胞在一系列显微镜图像中进入和离开焦点。GPT‑5.6 Sol 为细胞的明显消失寻找生物学解释,而 GPT‑6 Astra 正确识别出 z 堆栈:在不同深度拍摄的一系列图像。
0 秒
3 秒
6 秒
9 秒
12 秒
15 秒
原始记录中的六帧。虚线框标记显微镜扫描深度时相同的位置。时间指所提供视频中的播放位置。
更高的基准分数尚不意味着模型能在实验室中做出可靠判断。这些 Astra 示例展示了假设、预期答案和提供的标签如何可能压倒证据,以及正确的中间观察如何未能引导最终决策。
Astra 让熟悉的假设压倒了实验对照所支持的解读。 它能区分两组菌落条带,但假设较大的 PCR 产物会标识成功克隆。基于该条件,它提出泳道 4、6、7 和 8;参考的对照比较则选择泳道 5、9 和 10。
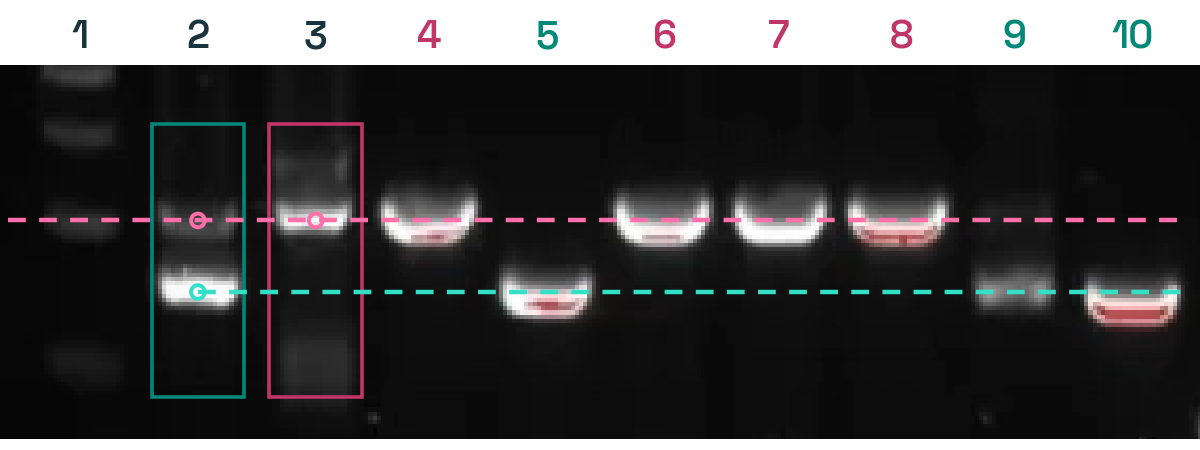
参考选择菌落 5、9 和 10*;Astra 提出* 4、6、7 和 8*。*
1:标记 · 2:克隆混合物 · 3:原始质粒 · 4–10:菌落样品
读取对照
- 泳道 3 仅包含原始质粒 PCR。其条带提供旧质粒参考位置。
- 在参考解读中,泳道 2 包含两种模式:不完整组装使旧模板/骨架与新产物并存。
- 所得菌落可能携带旧质粒或新质粒。将其条带与这些参考模式进行比较。
**参考选择:**5、9 和 10
**Astra 的选择:**4、6、7 和 8。Astra 提名这一组,认为较大的 PCR 产物代表预期构建体。
视觉分组是正确的,但附加到这些组上的实验身份相对于参考是颠倒的。因此,Astra 从菌落 PCR 结果中选择了错误的菌落,这将导致下游纯化出错误的质粒。
**Astra 贬低与其偏好解释相矛盾的观察结果。**它得出结论认为,细胞内的区室——液泡——通常比周围细胞更暗,尽管同一图像中有些液泡显得更亮。两种外观都很重要:改变显微镜的焦点可以反转对比度,因此较暗的示例并不能确立一般规律。
较暗外观
较亮外观
Astra 关于较暗液泡的概括遗漏了同一视野中可见的较亮液泡。
该答案遗漏了什么
有些细胞具有相反的对比度。两种外观都会出现,因为不同的焦深可以反转对比度。
Astra 检查了多个区域,甚至评论说对比度随焦点变化。然后它更重视其称为对焦更好的细胞,并在最终答案中只保留它们的较暗液泡描述。矛盾的较亮区域已被检查,但未在结论中考虑。
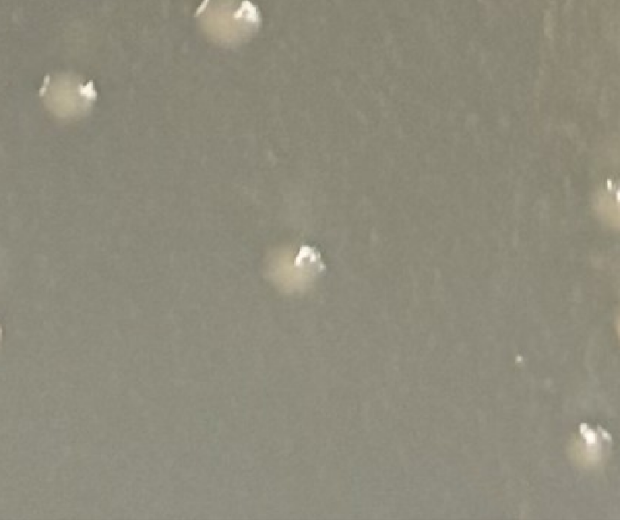
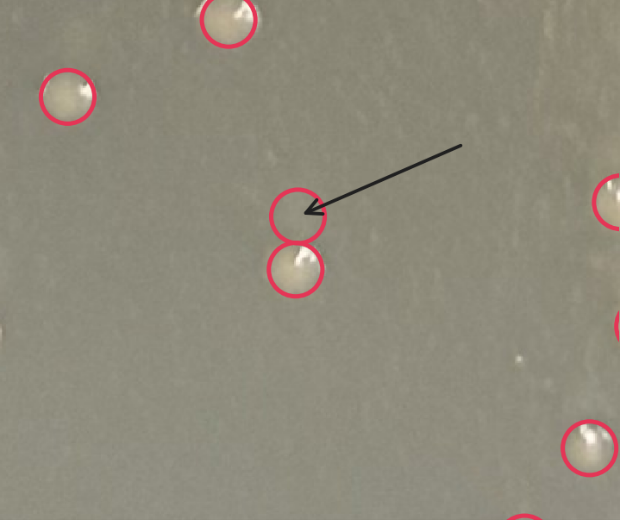
**Astra 的计数标记不能可靠地对应单个菌落:它未能分辨邻近菌落、遗漏可见菌落,并将空琼脂标记为菌落。**该培养皿上的净结果相对于基准参考高估了约 12%。
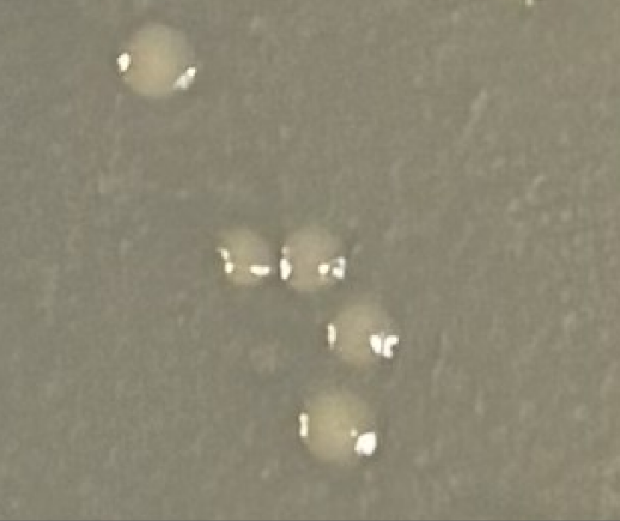
原始图像
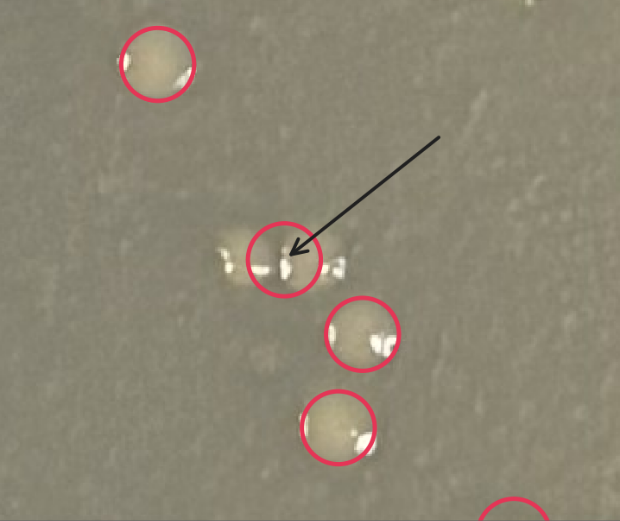
Astra 的计数标记
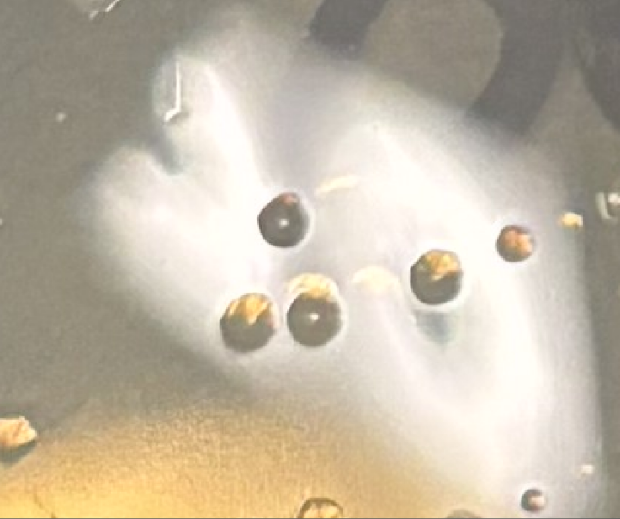
原始图像
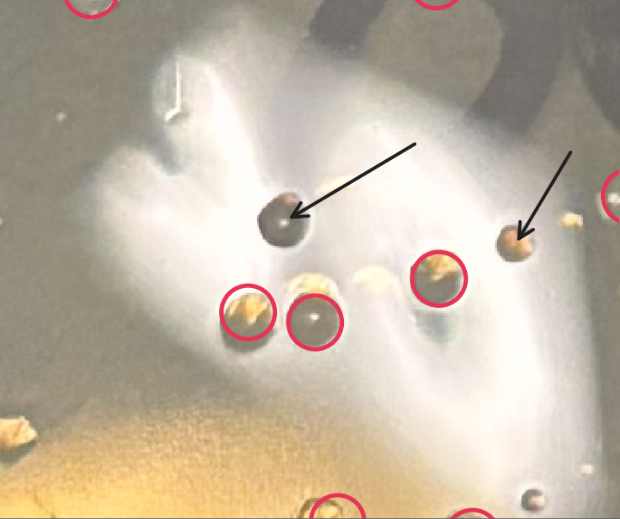
Astra 的计数标记
原始图像
Astra 的计数标记
A:相邻菌落之间的一个计数标记。B:两个可见菌落未被标记。C:空琼脂被计为一个菌落。红圈表示 Astra 的计数位置。黑色箭头为编辑指引。
不准确的菌落计数会直接影响对 DNA 导入细胞效率的估计。在接种体积和稀释度固定的情况下,高估会以相同比例夸大该估计值。
加速生物学研究需要把日常工作做对。BioBasicsBench 将这项工作作为改进目标:解读原始实验数据、检查对照,以及识别结论何时缺乏支持。在这些任务上取得进展,可以帮助科学家减少排查故障的时间,把更多时间用于决定接下来要开展哪些实验。跟踪这些能力也将帮助我们理解其对生物安全和生物安保的影响。
作者
继续阅读
原文链接: 衡量AI智能体如何处理日常湿实验室科学工作
评论