不复制海量数据,直接查询 S3:CSIRO 重构基因组分析架构
来源:InfoQ中文
本文为资讯聚合内容,版权归原作者及原网站所有,如有侵权请联系删除。
CSIRO 开发了 Serverless Beacon(sBeacon),这是一种用于查询基因组变异数据的无服务器架构,无须将大型基因组数据集复制到中央数据库。该系统使用 Amazon S3、AWS Lambda、Amazon Athena 和 Amazon DynamoDB,实现了全球基因组学与健康联盟(GA4GH)的 Beacon 标准。它可以对大型队列进行基因组查询,同时将底层数据保留在原始存储位置。
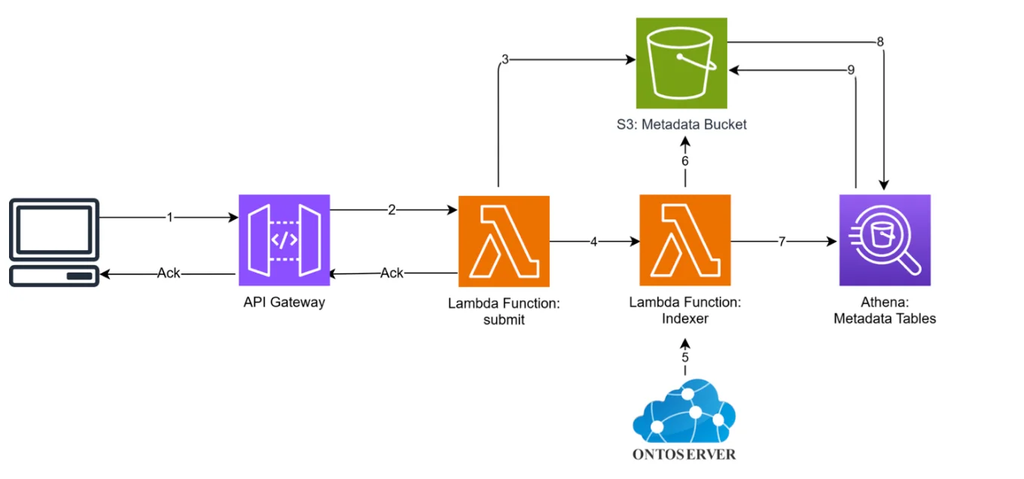
该架构将基因组数据与搜索所需的元数据分离。变异调用格式(VCF)文件保留在 Amazon S3 中,疾病状态、年龄和位置等元数据则单独建立索引。接入数据时,sBeacon 会为元数据创建索引和 Athena 表,并通过 CSIRO 的 Ontoserver 处理本体术语,以支持结合基因组和表型信息的查询。
对于变异查询,API Gateway 会将请求路由至 Lambda 函数,由这些函数确定相关数据集和基因组区域。变异查询模块使用 bcftools 及其 htslib 库,通过 HTTP 字节范围请求获取 VCF 文件的特定部分。这样,系统无须传输完整文件,即可读取所需的基因组区域。查询结果经过汇总后,通过 Beacon API 返回。
CSIRO 前生物信息学产品解决方案架构师 Anuradha Wickramarachchi 在个人 LinkedIn 帖子中强调了数据压缩的重要性:
我们认真考虑的一项关键因素,是让数据保持最高程度的压缩。在数据仍处于压缩状态时直接进行查询,可以带来很大优势。
CSIRO 使用千人基因组计划的 1 号染色体数据对 sBeacon 进行了评估,其中包含 2504 个样本,压缩后的 VCF 文件大小为 1.1GB,并存储在 Amazon S3 中。系统用时 18 秒、花费 0.00052 美元完成数据集接入,其间只创建索引文件,并未复制基因组数据。一次覆盖 1 万个碱基对的查询平均耗时 1.52 秒,成本为 0.00013 美元。CSIRO 报告称,当返回的变异数量从 4 个增加到 400 个,即增长 100 倍时,查询时间总体保持稳定。
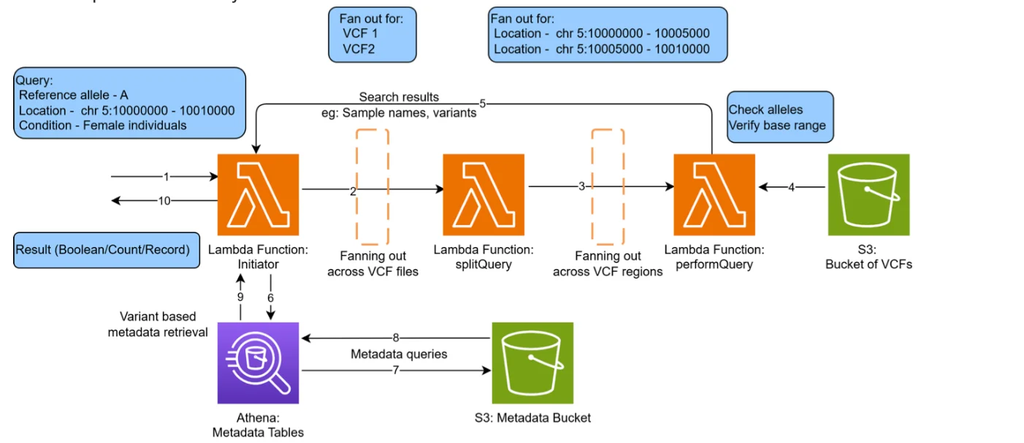
该设计建立在此前发表于 Nature Biotechnology 的 sBeacon 研究基础上。该研究报告称,sBeacon 最多可以支持 4000 万个个体和 30 亿个基因组位置。最初的 Beacon 研究描述了一种联合式模型,让组织可以在保留基因组数据控制权的同时,对外提供标准化查询接口。GA4GH 协议旨在跨分布式数据源运行,而不规定底层存储技术。2026 年的实现利用云服务扩展了这一模型,在将基因组文件保留在对象存储中的同时,提供弹性查询执行能力。
原文链接:
https://www.infoq.com/news/2026/10/csiro-serverless-genomic-variant/
评论